


Cách triển khai observability cho ứng dụng đám mây và microservices như thế nào
19/10/2026Khi một ứng dụng được tách thành hàng chục microservice chạy trên nhiều container, một request của người dùng có thể đi qua rất nhiều service trước khi trả về kết quả. Khi có sự cố, việc chỉ nhìn vào log của từng service riêng lẻ hoặc một vài dashboard CPU/RAM không còn đủ để biết vấn đề nằm ở đâu. Observability ra đời để giải quyết bài toán này, giúp đội kỹ thuật không chỉ biết "hệ thống đang gặp lỗi" mà còn hiểu được "tại sao lỗi lại xảy ra".
Bài viết trình bày khái niệm observability, các tín hiệu cốt lõi, quy trình triển khai từng bước, công cụ phổ biến và những thách thức thường gặp khi áp dụng cho ứng dụng đám mây và microservices.
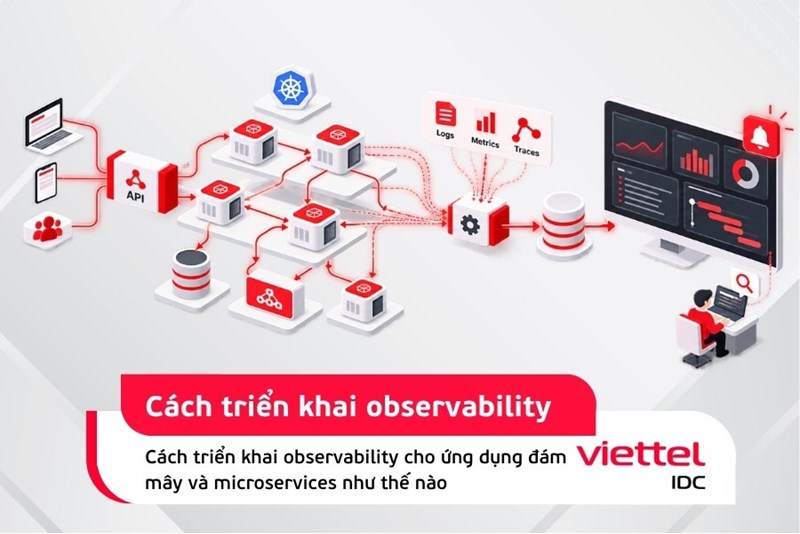
Observability là gì và khác monitoring thế nào?
Observability là khả năng suy luận về trạng thái nội bộ của một hệ thống dựa trên dữ liệu mà hệ thống đó tạo ra, phổ biến nhất là logs, metrics và traces. Khái niệm này vốn bắt nguồn từ lý thuyết điều khiển (control theory), sau đó được áp dụng vào kỹ thuật phần mềm để mô tả mức độ một hệ thống có thể được "quan sát" từ bên ngoài thông qua output của nó.
Monitoring và observability thường bị dùng lẫn nhau nhưng có phạm vi khác nhau. Monitoring tập trung phát hiện các vấn đề đã biết trước, còn observability hướng đến điều tra cả những vấn đề chưa từng gặp:
Một hệ thống có thể được monitor tốt (nhiều dashboard, nhiều alert) nhưng vẫn thiếu observability nếu đội kỹ thuật không thể truy vết nguyên nhân gốc khi có sự cố mới phát sinh.
Với ứng dụng monolith truyền thống, một lỗi thường có thể được xác định qua log của một tiến trình duy nhất. Với kiến trúc cloud-native và microservices, một request đi qua nhiều service độc lập, giao tiếp qua network, có thể chạy trên nhiều node hoặc nhiều cluster. Lỗi ở một service có thể gây ảnh hưởng dây chuyền (cascading failure) sang các service khác, khiến việc xác định nguyên nhân gốc khó hơn nhiều nếu không có cơ chế quan sát xuyên suốt toàn hệ thống.
Các tín hiệu cốt lõi của observability
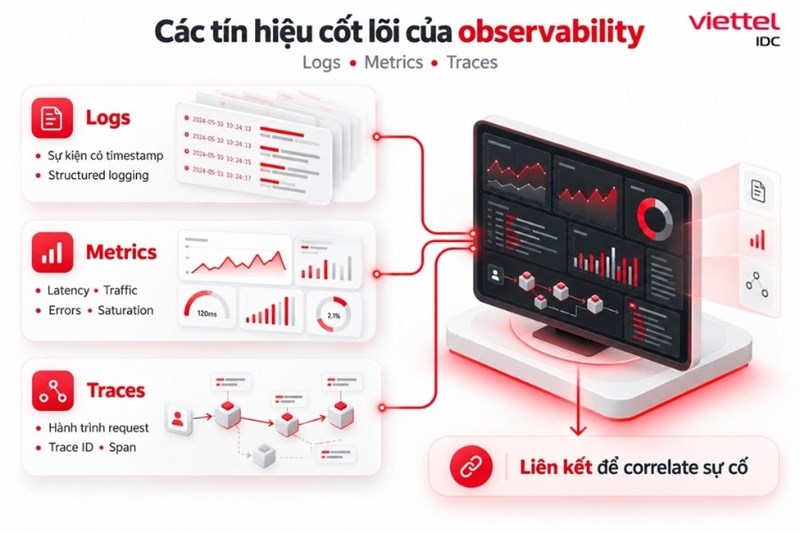
Logs
Logs là các bản ghi sự kiện dạng văn bản, thường kèm timestamp, mức độ nghiêm trọng (log level) và nội dung mô tả sự kiện. Trong hệ thống hiện đại, structured logging (log ở định dạng có cấu trúc như JSON thay vì văn bản tự do) được khuyến khích vì giúp việc tìm kiếm, lọc và phân tích log bằng công cụ tự động dễ dàng hơn nhiều so với log dạng text thuần.
Metrics
Metrics là các giá trị số được đo theo thời gian, ví dụ số request mỗi giây, độ trễ phản hồi, tỷ lệ lỗi hay mức sử dụng tài nguyên. Một khung tham khảo phổ biến khi chọn metrics quan trọng là "four golden signals" do Google SRE đề xuất:
- Latency: độ trễ phản hồi
- Traffic: lưu lượng request
- Errors: tỷ lệ lỗi
- Saturation: mức độ bão hòa tài nguyên
Traces
Traces ghi lại hành trình của một request khi nó đi qua nhiều service trong hệ thống phân tán. Mỗi trace bao gồm nhiều span, mỗi span đại diện cho một đơn vị công việc (ví dụ một lệnh gọi API hoặc một truy vấn database). Các span trong cùng một trace chia sẻ trace ID; mỗi span có span ID riêng và quan hệ parent-child thể hiện chuỗi xử lý. Distributed tracing giúp xác định chính xác service nào gây ra độ trễ hoặc lỗi trong một chuỗi gọi liên service, điều mà log hoặc metric đơn lẻ khó thể hiện được.
Trong thực tế, ba tín hiệu này nên được thiết kế để có thể liên kết (correlate) với nhau ngay từ đầu, thay vì triển khai tuần tự rồi mới nghĩ cách kết nối. Một alert dựa trên metric cần có thể dẫn tới trace liên quan, và trace đó cần có thể dẫn tới log chi tiết của đúng request đang gặp vấn đề.
Cách triển khai observability cho ứng dụng đám mây và microservices
Bước 1: Xác định mục tiêu observability và SLI/SLO
Trước khi thu thập dữ liệu, cần xác định rõ:
- Service nào quan trọng nhất đối với trải nghiệm người dùng
- User journey nào cần được theo dõi sát
- SLI (Service Level Indicator): chỉ số đo lường thực tế
- SLO (Service Level Objective): mục tiêu cần đạt, ví dụ độ trễ p95 dưới 300ms hoặc tỷ lệ lỗi dưới 0,1%
Thu thập dữ liệu trước rồi mới tìm cách sử dụng thường dẫn đến khối lượng telemetry lớn nhưng thiếu định hướng.
Bước 2: Chuẩn hóa telemetry và metadata
Trước khi instrument ứng dụng, cần thống nhất quy ước đặt tên và gắn metadata cho toàn bộ hệ thống, bao gồm:
- Tên service (service.name)
- Môi trường (environment)
- Cluster và namespace
- Phiên bản (version)
- Cách truyền trace ID
Nếu mỗi team tự đặt tên service hoặc gắn nhãn khác nhau, việc tổng hợp dashboard và liên kết dữ liệu giữa các service sẽ nhanh chóng trở nên rối loạn khi hệ thống mở rộng.
Bước 3: Instrument ứng dụng và truyền trace context
Instrumentation là quá trình gắn thêm đoạn mã hoặc agent vào ứng dụng để thu thập telemetry. OpenTelemetry là framework mã nguồn mở, vendor-neutral được dùng phổ biến cho việc này, hỗ trợ cả auto-instrumentation (tự động, ít cần sửa code) lẫn SDK thủ công cho các điểm cần tùy chỉnh sâu hơn. Việc instrument không chỉ dừng ở việc "gắn SDK" mà cần:
- Tạo span ở các điểm xử lý quan trọng
- Emit metrics liên quan
- Ghi structured log
- Truyền trace context giữa các lời gọi HTTP, gRPC hoặc qua message queue
Mục tiêu không phải thu thập càng nhiều telemetry càng tốt, mà là giữ được mối liên hệ giữa các service trong cùng một request khi nó đi qua nhiều thành phần của hệ thống.
Bước 4: Xây dựng pipeline thu thập telemetry
Telemetry sau khi được sinh ra tại ứng dụng cần được thu thập và chuyển tới nơi lưu trữ. Mô hình phổ biến là:
Application → OpenTelemetry SDK/Agent → OpenTelemetry Collector → observability backend
OpenTelemetry Collector đóng vai trò trung gian vendor-neutral, nhận, xử lý (ví dụ lọc, gộp, chuyển đổi định dạng) và export telemetry tới một hoặc nhiều backend khác nhau. Trong môi trường Kubernetes, pipeline này còn có thể thu thập thêm telemetry ở cấp hạ tầng như node, pod, container và các Kubernetes event, bên cạnh telemetry do ứng dụng sinh ra.
Bước 5: Lưu trữ, correlation và trực quan hóa
Mỗi loại tín hiệu thường cần một backend lưu trữ phù hợp:
- Metrics → hệ thống time series
- Logs → hệ thống log aggregation
- Traces → hệ thống tracing backend
- Toàn bộ được hiển thị tập trung qua công cụ visualization
Yếu tố quan trọng hơn việc chọn công cụ nào là khả năng correlation: từ một alert có thể lần theo metric liên quan, từ metric lần ra trace, từ trace lần tới đúng log của request và service đang gặp vấn đề.
Bước 6: Thiết lập alert dựa trên SLO
Alert nên được thiết lập dựa trên các tín hiệu phản ánh trải nghiệm người dùng và mục tiêu SLO, như:
- Tỷ lệ lỗi
- Độ trễ
- Khả năng khả dụng (availability)
- Mức độ bão hòa tài nguyên
- Error budget
thay vì chỉ đặt ngưỡng đơn giản kiểu "cảnh báo khi CPU vượt 80%". Alert dựa trên ngưỡng tài nguyên thuần túy dễ gây nhiễu (alert fatigue) và không phản ánh trực tiếp mức độ ảnh hưởng tới người dùng.
Bước 7: Tối ưu sampling, retention, cardinality và chi phí
Đây là bước dễ bị bỏ qua nhưng quan trọng khi đưa hệ thống observability vào vận hành thực tế ở quy mô lớn. Cần kiểm soát:
- Sampling cho tracing: không nhất thiết phải ghi lại 100% request
- Retention: thời gian lưu trữ cho từng loại dữ liệu
- Cardinality của metrics: số lượng giá trị khác nhau của một nhãn
- Dữ liệu nhạy cảm như PII hoặc secret: tránh để lọt vào log
- Lượng telemetry ingest và chi phí lưu trữ/truy vấn
Một lưu ý kỹ thuật đáng chú ý là nên tránh gắn các nhãn (label) có cardinality cao như request ID hay trace ID trực tiếp vào metric labels, vì có thể gây ra tình trạng "cardinality explosion" làm hệ thống lưu trữ metrics quá tải. Các giá trị này nên được đưa vào structured metadata của log hoặc trace thay vì gắn làm label của metric.
Các công cụ observability phổ biến
Một điểm cần làm rõ: OpenTelemetry không phải là một observability backend hoàn chỉnh, mà là một framework và bộ công cụ vendor-neutral dùng để instrument, thu thập và export telemetry; việc lưu trữ và trực quan hóa dữ liệu được giao cho các hệ thống backend khác. Dưới đây là cách phân nhóm các công cụ phổ biến theo vai trò trong một pipeline observability, chỉ mang tính minh họa, không phải danh sách đầy đủ:
Prometheus và Grafana: Prometheus là hệ thống monitoring và alerting lưu trữ metrics dưới dạng time series, thường được kết hợp với Grafana để xây dựng dashboard trực quan.
Jaeger: Jaeger vẫn là lựa chọn phổ biến cho tracing, nhưng nên dùng Jaeger v2 thay vì v1. Jaeger v1 đã kết thúc vòng đời hỗ trợ ngày 31/12/2025. Jaeger v2 được xây dựng trên nền OpenTelemetry Collector, hỗ trợ nhận dữ liệu qua giao thức OTLP một cách native.
Loki và Elastic Stack: Đây là hai lựa chọn phổ biến cho logs. Elastic hiện cũng hỗ trợ liên kết trực tiếp giữa log và trace tương ứng, minh họa cho việc correlation giữa các tín hiệu là một thực hành phổ biến trong observability hiện đại chứ không chỉ là lý thuyết.
Thách thức khi triển khai observability cho microservices
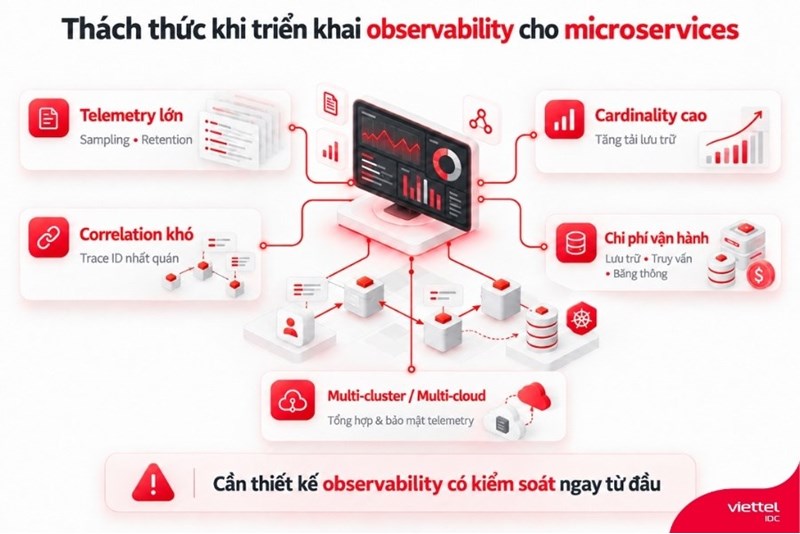
- Khối lượng telemetry lớn: hệ thống microservices quy mô lớn sinh ra lượng dữ liệu đáng kể, đòi hỏi chiến lược sampling và retention hợp lý thay vì thu thập toàn bộ
- Cardinality cao của metrics: nếu không kiểm soát, có thể làm hệ thống lưu trữ quá tải hoặc tăng chi phí đáng kể
- Correlation khó đảm bảo: liên kết logs, metrics và traces của cùng một request đòi hỏi trace ID và metadata được truyền nhất quán xuyên suốt, không dễ nếu các service được nhiều team phát triển độc lập
- Chi phí vận hành: lưu trữ, truy vấn và băng thông cho nền tảng observability cần được theo dõi thường xuyên để tránh phát sinh ngoài dự tính
- Hệ thống multi-cluster/multi-cloud: tổng hợp telemetry về một điểm quan sát duy nhất và đảm bảo bảo mật cho dữ liệu telemetry (vốn có thể chứa thông tin nhạy cảm) làm tăng thêm độ phức tạp của bài toán
Các phương pháp tốt nhất khi vận hành observability
Khi hệ thống đã đi vào vận hành, observability cần được duy trì như một phần của quy trình engineering thay vì chỉ được sử dụng khi xảy ra sự cố. Một số nguyên tắc nên duy trì gồm:
- Instrument observability ngay từ giai đoạn thiết kế hệ thống, thay vì bổ sung sau khi đã gặp sự cố trong môi trường production
- Thống nhất quy ước đặt tên và gắn nhãn (naming convention) cho service, môi trường và metadata trên toàn tổ chức
- Truyền trace context xuyên suốt qua mọi lời gọi giữa các service, kể cả qua message queue hoặc batch job
- Tổ chức dashboard theo service và theo SLO, thay vì chỉ theo loại tài nguyên hạ tầng
- Không thiết lập alert cho mọi metric thu thập được, vì sẽ gây alert fatigue và làm giảm độ nhạy của đội vận hành với các cảnh báo thực sự quan trọng
- Rà soát định kỳ chi phí telemetry (khối lượng ingest, retention, cardinality) để đảm bảo hệ thống observability không trở thành gánh nặng vận hành ngoài dự tính
Kết luận
Observability là năng lực và tập hợp thực hành giúp đội kỹ thuật hiểu trạng thái và hành vi của hệ thống thông qua telemetry, trong đó logs, metrics và traces là những tín hiệu phổ biến nhất, đặc biệt quan trọng với kiến trúc cloud-native và microservices nơi một request có thể đi qua nhiều service độc lập. Triển khai observability hiệu quả đòi hỏi xác định mục tiêu rõ ràng ngay từ đầu, chuẩn hóa telemetry, xây dựng pipeline thu thập hợp lý và kiểm soát chi phí vận hành, hơn là chỉ đơn thuần cài đặt công cụ.
Với các doanh nghiệp đang triển khai ứng dụng theo kiến trúc microservices trên Kubernetes, việc tự xây dựng và vận hành hạ tầng cluster cùng hệ thống giám sát đi kèm đòi hỏi thêm nguồn lực kỹ thuật chuyên trách. Viettel Open Kubernetes Service (vOKS) là dịch vụ nền tảng Kubernetes được Viettel IDC xây dựng trên kiến trúc Cloud Native, tích hợp sẵn khả năng giám sát và logging ở cấp hạ tầng Kubernetes (cluster, node, pod cùng các chỉ số CPU, Memory, Network, Storage, theo dõi sự kiện theo thời gian thực và lịch sử tác động người dùng), giúp doanh nghiệp có sẵn nền tảng giám sát hạ tầng khi triển khai cluster thay vì phải tự xây dựng từ đầu. Phần observability ở cấp ứng dụng, như distributed tracing hay correlation giữa các service theo quy trình 7 bước nêu trên, vẫn cần được đội phát triển tự instrument và cấu hình riêng.
Doanh nghiệp có thể tìm hiểu chi tiết về dịch vụ này tại https://viettelidc.com.vn/viettel-kubernetes-service
Để tìm hiểu thêm về dịch vụ, vui lòng liên hệ đến Viettel IDC:
- Hotline: 1800.8088 (miễn phí cước gọi)
- Fanpage: https://www.facebook.com/viettelidc
- Website: https://viettelidc.com.vn/
Viettel IDC - Nhà cung cấp dẫn đầu về giải pháp Trung tâm dữ liệu và Điện toán đám mây tại Việt Nam
Tin liên quan
Lỗi msvcr100.dll là gì? Hướng dẫn cách sửa lỗi msvcr100 dll nhanh chóng
Lỗi msvcr100.dll khiến phần mềm không khởi chạy trên Windows. Xem hướng dẫn khắc phục từng bước để bổ sung thư viện còn thiếu và sửa chữa chương trình bị lỗi.
Top 20 các extension visual studio code hữu ích cho lập trình viên
Các extension Visual Studio Code hữu ích mở rộng khả năng của trình soạn thảo, giúp lập trình viên tối ưu môi trường làm việc và nâng cao hiệu quả viết mã.
Bridge là gì? Cách hoạt động và ứng dụng trong mạng LAN
Bridge là gì? Cầu nối mạng hoạt động dựa trên địa chỉ MAC để kết nối các phân đoạn LAN, kiểm soát luồng dữ liệu và hỗ trợ triển khai mạng vật lý lẫn mạng ảo.
Lỗi Blocked due to other 4xx issue là gì? Nguyên nhân và cách fix lỗi
Lỗi Blocked due to other 4xx issue khiến Google không lập chỉ mục URL, cần xác định đúng mã HTTP và nguyên nhân để khắc phục hiệu quả trong Search Console.
Test case là gì? Cách viết test case và mẫu minh họa cho người mới
Test case là gì và làm sao để viết rõ ràng, đúng yêu cầu? Nắm vững cách xây dựng trường hợp kiểm thử qua ví dụ cụ thể để phát hiện sai lệch trong hoạt động phần mềm.
AI Inference là gì? Cơ chế và vai trò trong vận hành AI
AI inference là gì? Cách mô hình AI tạo kết quả sau huấn luyện, phân biệt với AI training, các hình thức triển khai và ứng dụng thực tế trong doanh nghiệp.
DBeaver là gì? Hướng dẫn cài đặt và kết nối cơ sở dữ liệu với DBeaver
DBeaver là gì? Khám phá tính năng quản lý cơ sở dữ liệu, các phiên bản miễn phí và trả phí cùng hướng dẫn cài đặt, kết nối, chạy truy vấn SQL cho người mới.
Cách thay đổi mật khẩu máy tính trên Windows 10, 11 đơn giản
Cách thay đổi mật khẩu máy tính trên Windows 10, 11 qua Settings, Control Panel, CMD và các công cụ quản trị được hướng dẫn chi tiết theo từng bước dễ thực hiện.
Microsoft Management Console là gì? Cách sử dụng MMC cho người mới
Microsoft Management Console là gì? Đây là nền tảng tập hợp các công cụ quản trị Windows, hỗ trợ quản lý hệ thống, thêm snap-in và lưu console theo nhu cầu sử dụng.
Rủi ro khi sử dụng giả lập online và cách phòng tránh
Rủi ro khi sử dụng giả lập online có thể gây lộ dữ liệu, mất quyền kiểm soát tài khoản, lừa đảo trực tuyến, vi phạm chính sách game, gián đoạn thao tác và phát sinh chi phí.
Bình luận ()