


Observability là gì? Vai trò, thành phần và cách triển khai hiệu quả
19/10/2026Observability là gì là câu hỏi được nhiều doanh nghiệp quan tâm khi hệ thống Cloud và Microservices ngày càng phức tạp. Giải pháp này giúp liên kết dữ liệu vận hành để xác định nguyên nhân sự cố. Nhờ đó, doanh nghiệp có thể xử lý lỗi nhanh hơn, cải thiện hiệu suất và nâng cao độ tin cậy của dịch vụ. Ở bài viết này, cùng Viettel IDC tìm hiểu chi tiết hơn về Observability và cách triển khai giải pháp này hiệu quả nhé.
Observability là gì?
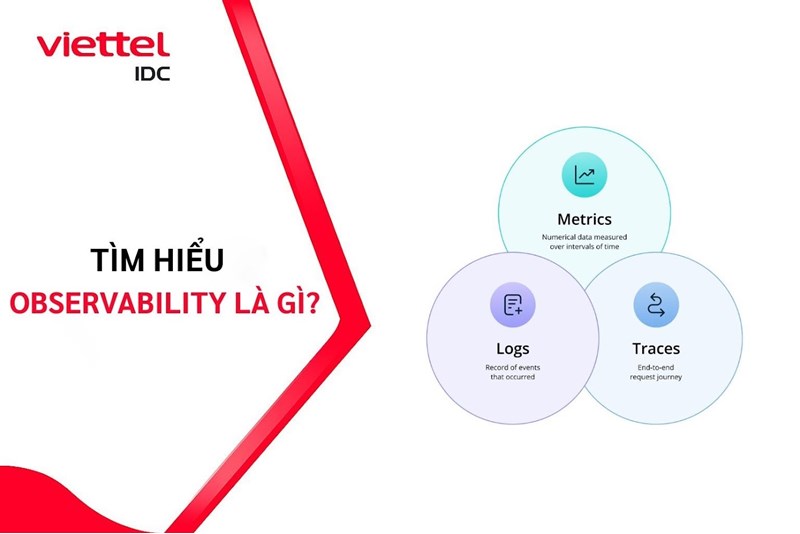
Observability (khả năng quan sát hệ thống) là khả năng hiểu trạng thái bên trong của một hệ thống thông qua dữ liệu mà hệ thống tạo ra trong quá trình hoạt động. Trong lĩnh vực công nghệ thông tin, dữ liệu này thường bao gồm Metrics, Logs và Traces, giúp đội ngũ kỹ thuật tìm hiểu cách ứng dụng vận hành, phát hiện bất thường và xác định nguyên nhân gây ra vấn đề.
Khác với việc chỉ kiểm tra một vài chỉ số riêng lẻ, Observability hướng đến việc kết hợp nhiều nguồn dữ liệu để trả lời các câu hỏi như:
- Vì sao website phản hồi chậm?
- Dịch vụ nào khiến API bị lỗi?
- Truy vấn cơ sở dữ liệu nào làm tăng thời gian xử lý?
- Sự cố xuất hiện sau lần cập nhật phần mềm nào?
Với Observability, đội ngũ kỹ thuật có thể xem biểu đồ thời gian phản hồi, kiểm tra log lỗi và theo dõi hành trình của yêu cầu qua từng dịch vụ. Nếu dữ liệu cho thấy phần lớn thời gian bị tiêu tốn khi truy vấn cơ sở dữ liệu, họ có thể tập trung kiểm tra câu lệnh SQL, chỉ mục hoặc tải hệ thống thay vì nâng cấp toàn bộ hạ tầng.
Observability hoạt động như thế nào?
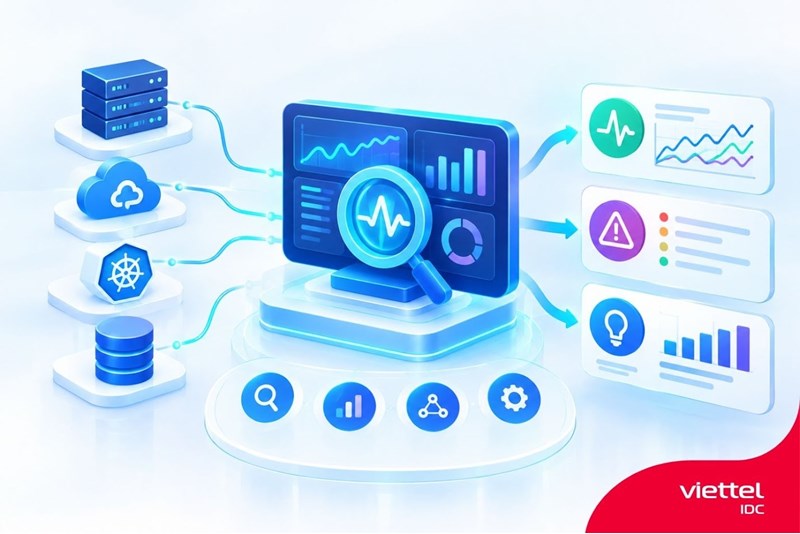
Observability hoạt động bằng cách thu thập dữ liệu từ ứng dụng, máy chủ, mạng, cơ sở dữ liệu và các thành phần liên quan, sau đó tập trung dữ liệu vào hệ thống phân tích để đội ngũ kỹ thuật theo dõi và điều tra vấn đề.
Quy trình thường gồm các hoạt động chính như:
- Thu thập dữ liệu: Ứng dụng và hạ tầng ghi nhận thông tin về hiệu suất, sự kiện, lỗi và quá trình xử lý yêu cầu. Dữ liệu được tạo ra thông qua các thư viện đo lường, tác nhân thu thập hoặc tích hợp có sẵn.
- Chuyển tiếp và xử lý: Dữ liệu được gửi đến hệ thống tiếp nhận để chuẩn hóa, lọc, bổ sung thông tin hoặc chuyển đến nơi lưu trữ. Một số kiến trúc sử dụng bộ thu thập trung gian để quản lý dữ liệu từ nhiều nguồn.
- Phân tích và trực quan hóa: Công cụ Observability hiển thị dữ liệu qua biểu đồ, bảng điều khiển và thông tin chi tiết về từng yêu cầu. Người dùng có thể đối chiếu các chỉ số với thời điểm phát sinh lỗi.
- Phát hiện bất thường và điều tra: Hệ thống có thể gửi cảnh báo khi chỉ số vượt ngưỡng hoặc xuất hiện dấu hiệu bất thường. Đội ngũ kỹ thuật tiếp tục phân tích dữ liệu liên quan để tìm nguyên nhân và xác định hướng khắc phục.
Ba thành phần cốt lõi của Observability
Observability dựa trên ba loại dữ liệu chính: Metrics, Logs và Traces. Khi kết hợp, chúng giúp đội ngũ kỹ thuật theo dõi hiệu suất, phát hiện bất thường và xác định nguyên nhân sự cố.
Metrics: Theo dõi chỉ số hiệu suất
Metrics là dữ liệu dạng số phản ánh tình trạng hệ thống theo thời gian, như mức sử dụng CPU, RAM, tỷ lệ lỗi và thời gian phản hồi. Các chỉ số này giúp nhận biết xu hướng bất thường và thiết lập cảnh báo, nhưng thường chưa đủ để xác định nguyên nhân cụ thể.
Logs: Ghi nhận sự kiện và lỗi
Logs lưu lại các sự kiện trong quá trình hệ thống hoạt động, chẳng hạn như lỗi đăng nhập, truy vấn thất bại hoặc dịch vụ không phản hồi. Nhờ đó, kỹ thuật viên có thể tìm hiểu điều gì đã xảy ra và khoanh vùng nguyên nhân. Doanh nghiệp cần tránh ghi lại mật khẩu và thông tin nhạy cảm không cần thiết.
Traces: Theo dõi hành trình yêu cầu
Traces ghi lại quá trình một yêu cầu đi qua các thành phần của hệ thống, từ đó xác định bước xử lý gây chậm hoặc phát sinh lỗi. Dữ liệu này đặc biệt hữu ích với kiến trúc Microservices, nơi một yêu cầu có thể đi qua nhiều dịch vụ trước khi hoàn tất.
Lợi ích của Observability đối với doanh nghiệp
Observability giúp doanh nghiệp giám sát hệ thống hiệu quả hơn, phát hiện sớm bất thường và hạn chế gián đoạn dịch vụ. Dưới đây là những lợi ích nổi bật của giải pháp này trong hoạt động vận hành và kinh doanh:
- Phát hiện và xử lý sự cố nhanh hơn: Observability kết hợp dữ liệu từ nhiều thành phần để giúp đội ngũ kỹ thuật xác định thời điểm xảy ra lỗi, khu vực bị ảnh hưởng và nguyên nhân tiềm ẩn. Thay vì kiểm tra từng máy chủ hoặc ứng dụng riêng lẻ, kỹ thuật viên có thể lần theo dữ liệu để khoanh vùng vấn đề nhanh hơn, giảm thời gian điều tra và hạn chế gián đoạn dịch vụ.
- Cải thiện hiệu suất và trải nghiệm người dùng: Thông tin về thời gian phản hồi, tỷ lệ lỗi và lưu lượng truy cập giúp doanh nghiệp nhận biết những điểm gây chậm trong hệ thống. Dựa trên kết quả phân tích, đội ngũ phát triển có thể tối ưu truy vấn cơ sở dữ liệu, điều chỉnh cấu hình hoặc cải thiện quy trình xử lý yêu cầu.
- Nâng cao độ tin cậy của hệ thống: Việc theo dõi dữ liệu vận hành liên tục giúp phát hiện những dấu hiệu bất thường trước khi chúng phát triển thành sự cố nghiêm trọng. Doanh nghiệp có thể thiết lập cảnh báo, theo dõi xu hướng lỗi và đánh giá các chỉ số như độ sẵn sàng, thời gian phản hồi hay tỷ lệ yêu cầu thành công. Đây là cơ sở để chủ động phòng ngừa rủi ro và duy trì hoạt động ổn định.
- Tối ưu tài nguyên và chi phí vận hành: Dữ liệu sử dụng CPU, RAM, lưu trữ và lưu lượng truy cập cho biết hệ thống đang thiếu hay dư thừa tài nguyên. Từ đó, doanh nghiệp có thể điều chỉnh cấu hình, phân bổ tài nguyên theo nhu cầu thực tế và hạn chế nâng cấp hạ tầng không cần thiết.
Quy trình triển khai Observability hiệu quả
Để triển khai Observability hiệu quả, doanh nghiệp cần thực hiện 5 bước như sau:
Bước 1: Xác định mục tiêu và chỉ số cần theo dõi
Trước tiên, doanh nghiệp cần xác định vấn đề muốn cải thiện, chẳng hạn như giảm thời gian phản hồi, hạn chế lỗi, tăng độ sẵn sàng hoặc kiểm soát tài nguyên. Mục tiêu càng cụ thể, việc lựa chọn dữ liệu và đánh giá hiệu quả triển khai càng chính xác.
Các chỉ số cần theo dõi sẽ khác nhau tùy hệ thống. Với API, nên chú ý lưu lượng yêu cầu, tỷ lệ lỗi và độ trễ. Với cơ sở dữ liệu, cần theo dõi thời gian truy vấn, số kết nối và mức sử dụng tài nguyên. Đối với website bán hàng, có thể bổ sung tỷ lệ đặt hàng thành công và số giao dịch thất bại để đánh giá cả hiệu suất kỹ thuật lẫn trải nghiệm người dùng.
Bước 2: Thu thập Metrics, Logs và Traces
Sau khi xác định mục tiêu, doanh nghiệp cần thiết lập cơ chế thu thập ba loại dữ liệu chính: Metrics (chỉ số), Logs (nhật ký) và Traces (dấu vết truy vết). Các dữ liệu này lần lượt giúp theo dõi hiệu suất, ghi nhận sự kiện và tìm hiểu hành trình xử lý yêu cầu qua các thành phần của hệ thống.
Doanh nghiệp có thể sử dụng công cụ giám sát hạ tầng, thư viện đo lường trong ứng dụng hoặc giải pháp thu thập log và tracing phù hợp với công nghệ đang vận hành. Với kiến trúc phân tán, cần bổ sung thông tin nhận diện dịch vụ và truyền ngữ cảnh giữa các thành phần để liên kết các bước xử lý trong cùng một yêu cầu.
Bước 3: Tập trung và liên kết dữ liệu
Sau khi thu thập, dữ liệu cần được chuyển đến các hệ thống lưu trữ và phân tích phù hợp. Việc tập trung thông tin giúp đội ngũ kỹ thuật theo dõi toàn bộ hệ thống mà không phải kiểm tra từng máy chủ hay công cụ riêng biệt.
Quan trọng hơn, các dữ liệu cần được liên kết theo thời gian, dịch vụ, môi trường hoặc mã định danh yêu cầu khi có thể. Ví dụ, khi một trace cho thấy yêu cầu xử lý chậm, kỹ thuật viên có thể đối chiếu với log tương ứng và các chỉ số tại cùng thời điểm để tìm hiểu nguyên nhân.
Bước 4: Xây dựng dashboard và thiết lập cảnh báo
Dashboard cần thể hiện những thông tin quan trọng như độ trễ, tỷ lệ lỗi, lưu lượng truy cập và mức sử dụng tài nguyên. Cách trình bày nên rõ ràng, tập trung vào các chỉ số gắn với mục tiêu vận hành để đội ngũ kỹ thuật nhanh chóng nhận biết dấu hiệu bất thường.
Bên cạnh đó, doanh nghiệp nên thiết lập cảnh báo theo ngưỡng hoặc điều kiện phản ánh vấn đề thực tế. Chẳng hạn, hệ thống có thể gửi cảnh báo khi tỷ lệ lỗi tăng cao trong một khoảng thời gian hoặc thời gian phản hồi vượt mục tiêu đã đặt ra.
Bước 5: Phân tích sự cố và cải tiến liên tục
Khi xuất hiện cảnh báo, đội ngũ kỹ thuật cần kiểm tra dữ liệu để xác định thời điểm phát sinh, phạm vi ảnh hưởng và thành phần liên quan. Metrics giúp nhận diện xu hướng bất thường, Logs cung cấp thông tin chi tiết về sự kiện, còn Traces hỗ trợ tìm bước xử lý gây lỗi hoặc làm tăng độ trễ.
Sau khi khắc phục, doanh nghiệp cần đánh giá nguyên nhân gốc rễ và xác định những điểm cần cải thiện, chẳng hạn như bổ sung dữ liệu theo dõi, điều chỉnh ngưỡng cảnh báo hoặc tối ưu ứng dụng. Việc này giúp hạn chế nguy cơ lặp lại sự cố và nâng cao hiệu quả vận hành.
Kết luận
Observability giúp doanh nghiệp theo dõi tình trạng hệ thống thông qua Metrics, Logs và Traces, từ đó phát hiện sự cố, cải thiện hiệu suất và tối ưu tài nguyên. Hiểu rõ Observability là gì và triển khai đúng cách sẽ giúp đội ngũ kỹ thuật xác định nguyên nhân vấn đề nhanh hơn, đồng thời nâng cao độ ổn định và hiệu quả vận hành.
Để tìm hiểu thêm về dịch vụ, vui lòng liên hệ đến Viettel IDC:
- Hotline: 1800.8088 (miễn phí cước gọi)
- Fanpage: https://www.facebook.com/viettelidc
- Website: https://viettelidc.com.vn/
Viettel IDC - Nhà cung cấp dẫn đầu về giải pháp Trung tâm dữ liệu và Điện toán đám mây tại Việt Nam
Tin liên quan
Lỗi msvcr100.dll là gì? Hướng dẫn cách sửa lỗi msvcr100 dll nhanh chóng
Lỗi msvcr100.dll khiến phần mềm không khởi chạy trên Windows. Xem hướng dẫn khắc phục từng bước để bổ sung thư viện còn thiếu và sửa chữa chương trình bị lỗi.
Top 20 các extension visual studio code hữu ích cho lập trình viên
Các extension Visual Studio Code hữu ích mở rộng khả năng của trình soạn thảo, giúp lập trình viên tối ưu môi trường làm việc và nâng cao hiệu quả viết mã.
Bridge là gì? Cách hoạt động và ứng dụng trong mạng LAN
Bridge là gì? Cầu nối mạng hoạt động dựa trên địa chỉ MAC để kết nối các phân đoạn LAN, kiểm soát luồng dữ liệu và hỗ trợ triển khai mạng vật lý lẫn mạng ảo.
Lỗi Blocked due to other 4xx issue là gì? Nguyên nhân và cách fix lỗi
Lỗi Blocked due to other 4xx issue khiến Google không lập chỉ mục URL, cần xác định đúng mã HTTP và nguyên nhân để khắc phục hiệu quả trong Search Console.
Test case là gì? Cách viết test case và mẫu minh họa cho người mới
Test case là gì và làm sao để viết rõ ràng, đúng yêu cầu? Nắm vững cách xây dựng trường hợp kiểm thử qua ví dụ cụ thể để phát hiện sai lệch trong hoạt động phần mềm.
AI Inference là gì? Cơ chế và vai trò trong vận hành AI
AI inference là gì? Cách mô hình AI tạo kết quả sau huấn luyện, phân biệt với AI training, các hình thức triển khai và ứng dụng thực tế trong doanh nghiệp.
DBeaver là gì? Hướng dẫn cài đặt và kết nối cơ sở dữ liệu với DBeaver
DBeaver là gì? Khám phá tính năng quản lý cơ sở dữ liệu, các phiên bản miễn phí và trả phí cùng hướng dẫn cài đặt, kết nối, chạy truy vấn SQL cho người mới.
Cách thay đổi mật khẩu máy tính trên Windows 10, 11 đơn giản
Cách thay đổi mật khẩu máy tính trên Windows 10, 11 qua Settings, Control Panel, CMD và các công cụ quản trị được hướng dẫn chi tiết theo từng bước dễ thực hiện.
Microsoft Management Console là gì? Cách sử dụng MMC cho người mới
Microsoft Management Console là gì? Đây là nền tảng tập hợp các công cụ quản trị Windows, hỗ trợ quản lý hệ thống, thêm snap-in và lưu console theo nhu cầu sử dụng.
Rủi ro khi sử dụng giả lập online và cách phòng tránh
Rủi ro khi sử dụng giả lập online có thể gây lộ dữ liệu, mất quyền kiểm soát tài khoản, lừa đảo trực tuyến, vi phạm chính sách game, gián đoạn thao tác và phát sinh chi phí.
Bình luận ()